前回、Pgpool-IIを使ってPostgreSQLのストリーミングレプリケーション構成を管理するための構築手順を記載した。
Pgpool-IIでは、定期的にPostgreSQLに対してヘルスチェックを実行しており、マスターのDB停止を契機としてフェイルオーバー(スタンバイDBをマスターDBに昇格)を実行できる。
また、フェイルオーバー後に旧マスターをスタンバイDBとしてストリーミングレプリケーション構成に復旧させることもできる。この作業は、マスターDBのI/Oを停止させることなく実行できることから「オンラインリカバリ」と呼ばれる。
Pgpool-IIのフェイルオーバーやオンラインリカバリは、スクリプトにて実装される。本記事では、Pgpool-IIを使ってフェイルオーバーとオンラインリカバリを実行するための手順を記載する。
環境
OSはRHEL互換OSであるAlmaLinuxを利用し、パッケージ提供されているPostgreSQLを利用する。
- OS : AlmaLinux release 8.8
- PostgreSQL : 15.2
- Pgpool-II : 4.4.4
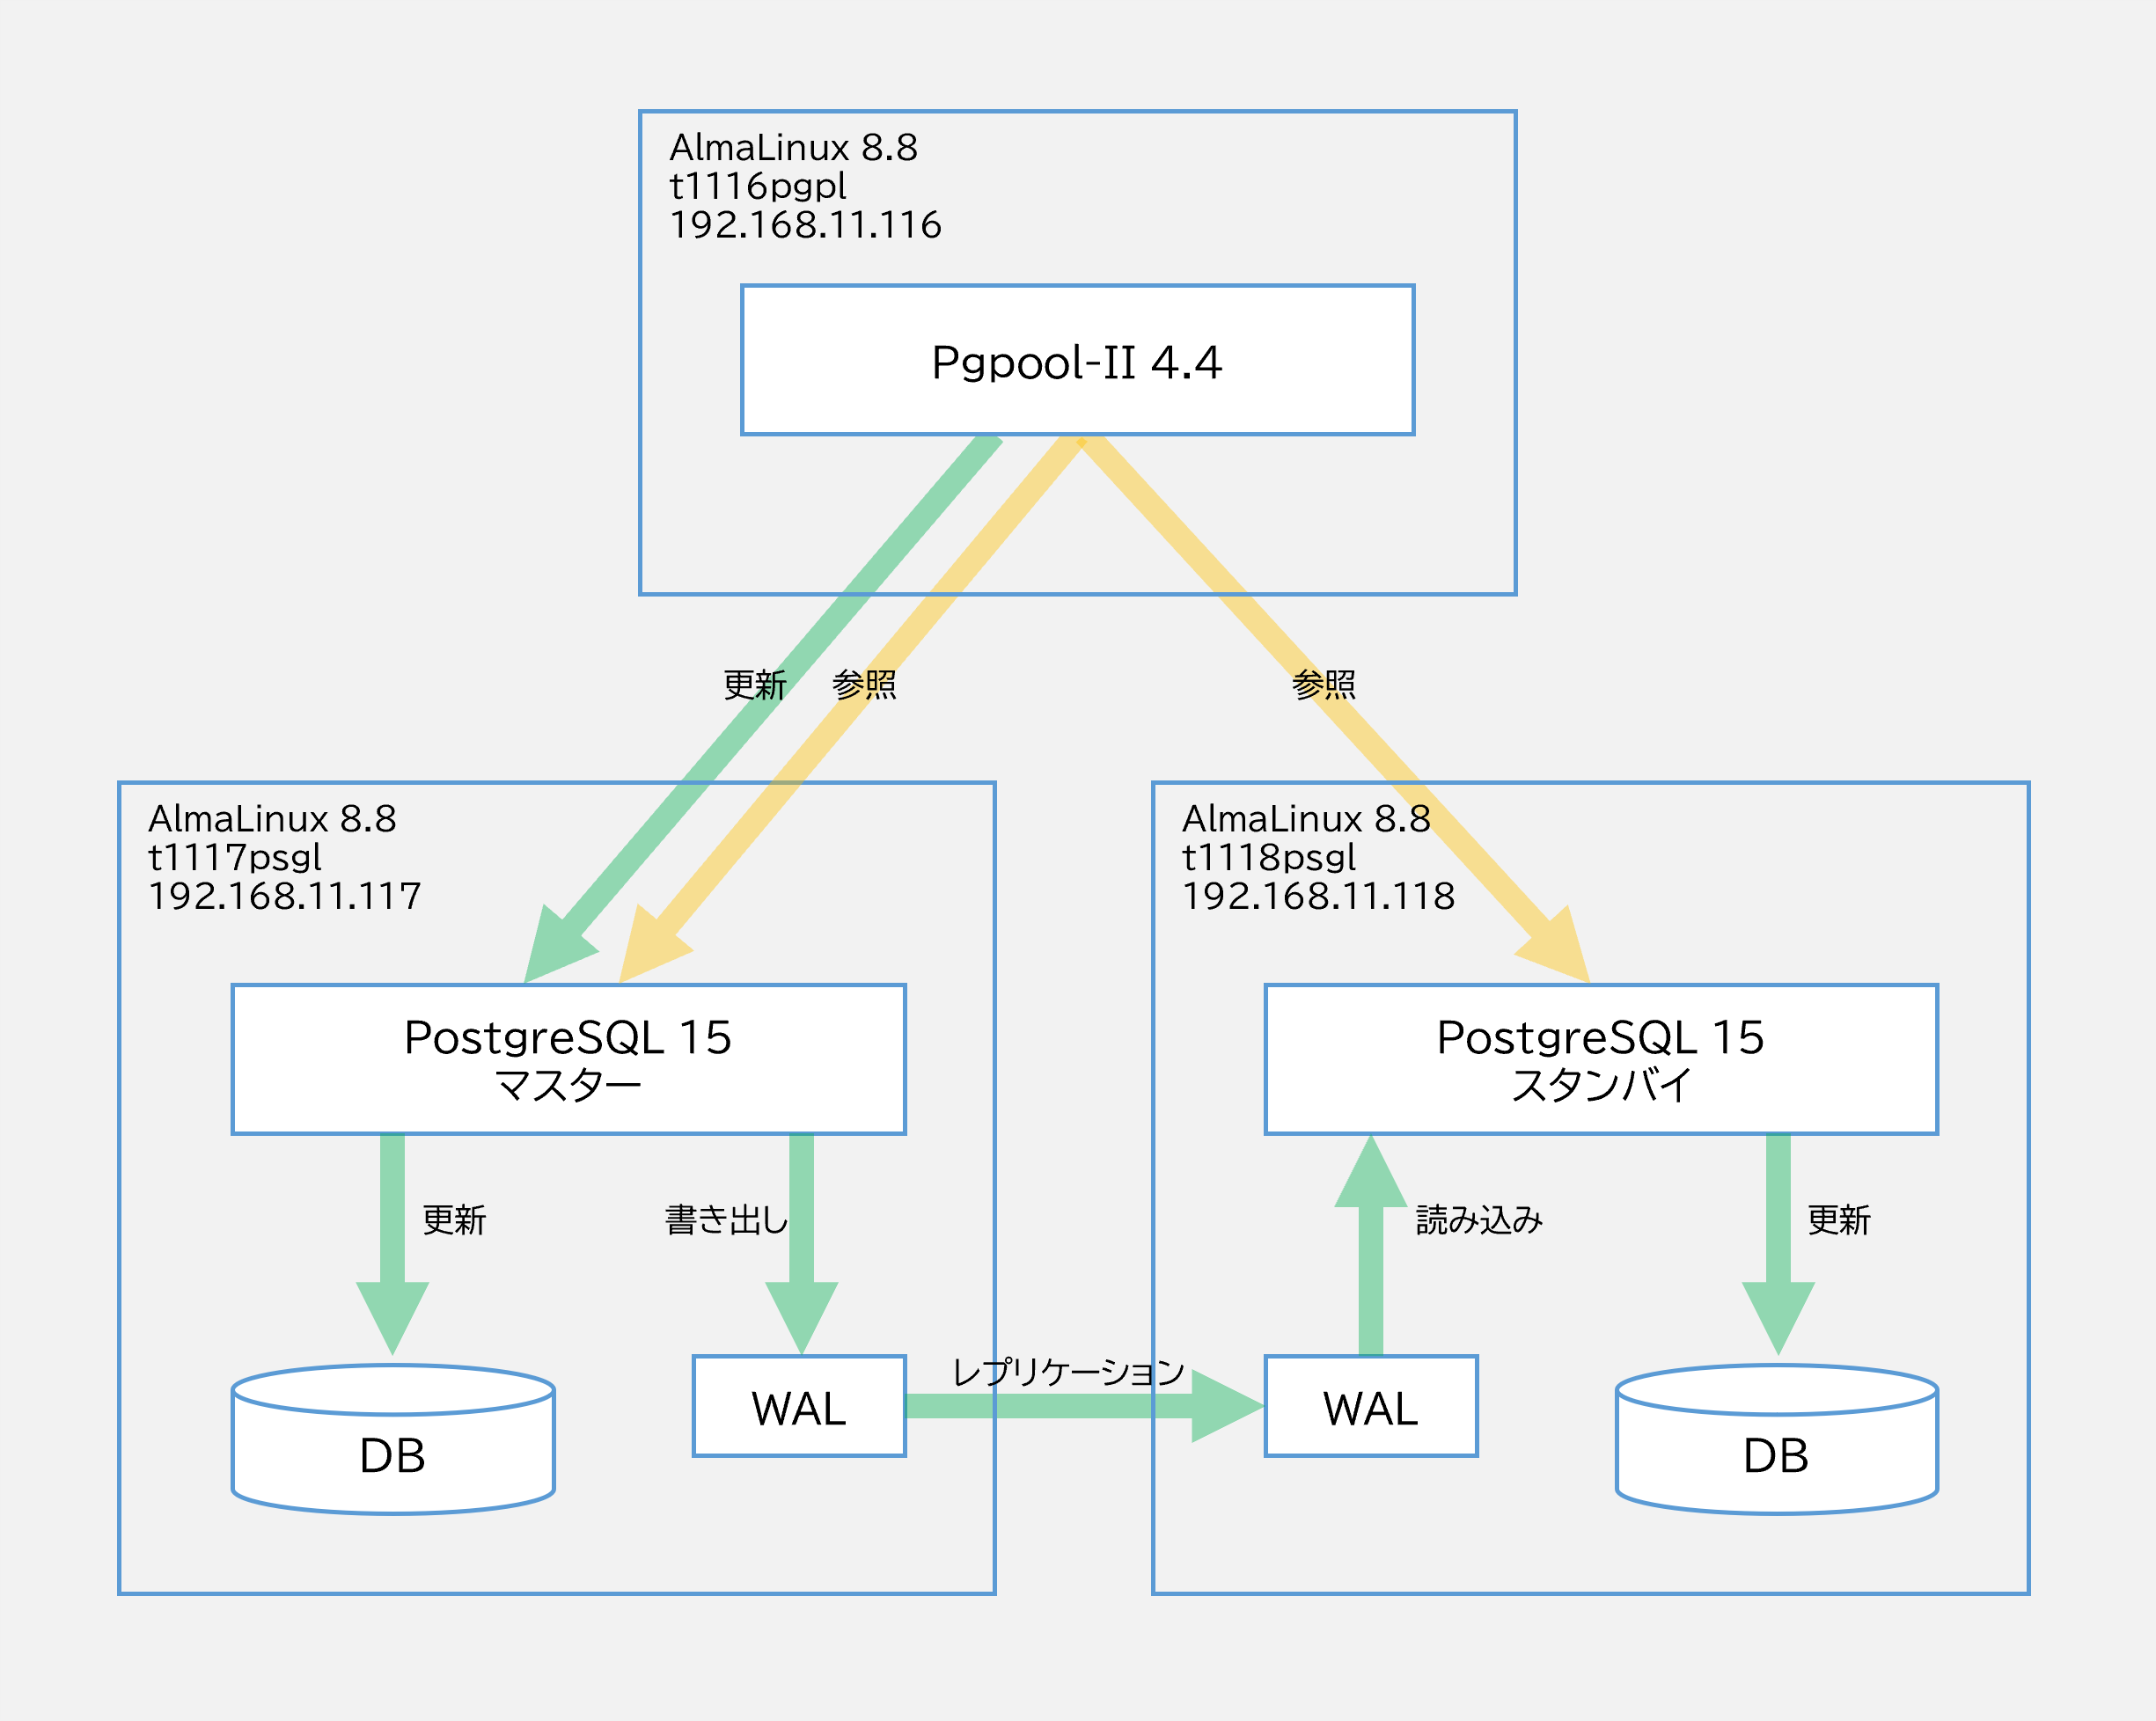
マスターとスタンバイの2台にPostgreSQLをインストールし、ストリーミングレプリケーションを構成する。ホスト名やIPアドレスは以下図を参照いただきたい。

今回はPgpool-II導入サーバ、マスターDBサーバ、スタンバイDBサーバで実施する作業が異なる。そのため、本記事で記載するプロンプトを以下の通り記載し、作業対象が判別できるようにした。
| プロンプト | ユーザー | 対象 |
|---|---|---|
| [Pgpool]# | root | Pgpool-II導入サーバのみ実施 |
| [Master/Standby]# | root | マスターとスタンバイ両方で実施 |
| [Master]# | root | マスターのみ実施 |
| [Standby]# | root | スタンバイのみ実施 |
| [Pgpool]$ | postgres | Pgpool-II導入サーバのみ実施 |
| [Master/Standby]$ | postgres | マスターとスタンバイ両方で実施 |
| [Master]$ | postgres | マスターのみ実施 |
| [Standby]$ | postgres | スタンバイのみ実施 |
スクリプト配置
Pgpool-IIのサンプルスクリプトは/etc/pgpool-II/sample_scripts/ディレクトリに存在する。そちらを使用してもよいが、不要な処理を削除してシンプルにしたいため、サンプルスクリプトは参考にしつつオリジナルのスクリプトを作成した。
以下サンプルスクリプトの一覧となる。
[Pgpool]$ ls -1 /etc/pgpool-II/sample_scripts/
aws_eip_if_cmd.sh.sample
aws_rtb_if_cmd.sh.sample
escalation.sh.sample
failover.sh.sample
follow_primary.sh.sample
pgpool_remote_start.sample
recovery_1st_stage.sample
replication_mode_recovery_1st_stage.sample
replication_mode_recovery_2nd_stage.sample
1. フェイルオーバー用スクリプトの作成・配置
フェイルオーバー用スクリプトの処理の流れを記載する。
- 引数を変数に代入する。
- 実行ユーザーをpostgresとして設定する。
- 昇格対象となるスタンバイDB(
NEW_MAIN_NODE_HOST)にSSH接続するための、SSHコマンド文を作成する。 - スタンバイDBをマスターDBとして昇格させる。
synchronous_standby_names='*'が設定されている場合、レプリケーション完了までDBが応答を返すことができず、実質更新ができなくなる。そのため、synchronous_standby_names=''のように空白設定に変更する。- 設定反映のため、昇格したDBの設定をリロードする。
実際のスクリプトを以下に記載する。本スクリプトは、Pgpool-II導入サーバの/var/lib/pgsqlに配置する。
failover.sh
#!/bin/bash
# This script is run by failover_command.

set -eu
set -o xtrace

# Special values:
# 1)  %d = failed node id
# 2)  %h = failed node hostname
# 3)  %p = failed node port number
# 4)  %D = failed node database cluster path
# 5)  %m = new main node id
# 6)  %H = new main node hostname
# 7)  %M = old main node id
# 8)  %P = old primary node id
# 9)  %r = new main port number
# 10) %R = new main database cluster path
# 11) %N = old primary node hostname
# 12) %S = old primary node port number
# 13) %% = '%' character

FAILED_NODE_ID="$1"
FAILED_NODE_HOST="$2"
FAILED_NODE_PORT="$3"
FAILED_NODE_PGDATA="$4"
NEW_MAIN_NODE_ID="$5"
NEW_MAIN_NODE_HOST="$6"
OLD_MAIN_NODE_ID="$7"
OLD_PRIMARY_NODE_ID="$8"
NEW_MAIN_NODE_PORT="$9"
NEW_MAIN_NODE_PGDATA="${10}"
OLD_PRIMARY_NODE_HOST="${11}"
OLD_PRIMARY_NODE_PORT="${12}"

POSTGRESQL_STARTUP_USER=postgres
SSH_KEY_FILE=id_rsa
SSH_OPTIONS="-o StrictHostKeyChecking=no -o UserKnownHostsFile=/dev/null -i ~/.ssh/${SSH_KEY_FILE}"
SSH_CMD="ssh -T ${SSH_OPTIONS} ${POSTGRESQL_STARTUP_USER}@${NEW_MAIN_NODE_HOST}"

${SSH_CMD} /usr/bin/pg_ctl promote -D ${NEW_MAIN_NODE_PGDATA} -w
${SSH_CMD} "sed -ie \"s/^synchronous_standby_names = '\*'/synchronous_standby_names = ''/g\" ${NEW_MAIN_NODE_PGDATA}/postgresql.conf"
${SSH_CMD} /usr/bin/pg_ctl reload -D ${NEW_MAIN_NODE_PGDATA} -w

exit 0
2. オンラインリカバリ用スクリプトの作成・配置
オンラインリカバリ用スクリプトの処理の流れを記載する。
- 引数を変数に代入する。
- レプリケーション用のDBユーザーをdbrepl、実行ユーザーをpostgresとして設定する。
- リカバリ対象となるスタンバイDB(
DEST_NODE_HOST)にSSH接続するための、SSHコマンド文を作成する。 - スタンバイDBのデータ領域を削除する。
pg_basebackupコマンドを使って、マスターDBのデータをスタンバイDBにコピー(ベースバックアップ)を行う。- スタンバイDBとして動作させるため、
standby.signalファイルを生成する。 postgresql.confに含まれるスタンバイDBのホスト名をマスターDBのホスト名に入れ替える。application_nameの設定値をスタンバイDBのホスト名に変更する。- マスターDBにてフェイルオーバー時に変更した
synchronous_standby_namesの設定値をsynchronous_standby_names='*'に戻し、レプリケーションを再開する。 - 設定反映のため、昇格したDBの設定をリロードする。
以下のスクリプトをPgpool-IIの管理対象となるDBサーバーのデータ領域(通常は/var/lib/pgsql/data)に配置する。
replication_mode_recovery_1st_stage
#!/bin/bash
# This script is executed by "recovery_1st_stage" to recovery a Standby node.

set -eu
set -o xtrace

MAIN_NODE_PGDATA="$1"              # main node dabatase cluster path
DEST_NODE_HOST="$2"                # hostname of the DB node to be recovered
DEST_NODE_PGDATA="$3"              # database cluster path of the DB node to be recovered
MAIN_NODE_PORT="$4"                # main node port number
DEST_NODE_ID="$5"                  # node id of the DB node to be recovered
DEST_NODE_PORT="$6"                # port number of the DB node to be recovered
MAIN_NODE_HOST="$7"                # main node hostname

REPLUSER=dbrepl
POSTGRESQL_STARTUP_USER=postgres
SSH_KEY_FILE=id_rsa
SSH_OPTIONS="-o StrictHostKeyChecking=no -o UserKnownHostsFile=/dev/null -i ~/.ssh/${SSH_KEY_FILE}"
SSH_CMD="ssh -T ${SSH_OPTIONS} ${POSTGRESQL_STARTUP_USER}@${DEST_NODE_HOST}"

# Standby側(オンラインリカバリされる側)の処理
${SSH_CMD} "[ -d ${DEST_NODE_PGDATA} ] && rm -rf ${DEST_NODE_PGDATA}"
${SSH_CMD} "/usr/bin/pg_basebackup -D ${DEST_NODE_PGDATA} -h ${MAIN_NODE_HOST} -X stream -c fast -U ${REPLUSER} -p ${MAIN_NODE_PORT} -w"
${SSH_CMD} "touch ${DEST_NODE_PGDATA}/standby.signal"

${SSH_CMD} "sed -ie \"s#${DEST_NODE_HOST}#${MAIN_NODE_HOST}#g\" ${DEST_NODE_PGDATA}/postgresql.conf"
${SSH_CMD} "sed -ie \"s#application_name=${MAIN_NODE_HOST}#application_name=${DEST_NODE_HOST}#g\" ${DEST_NODE_PGDATA}/postgresql.conf"

# Master側の処理
sed -ie "s/^synchronous_standby_names = ''/synchronous_standby_names = '\*'/g" ${MAIN_NODE_PGDATA}/postgresql.conf
/usr/bin/pg_ctl reload -D ${MAIN_NODE_PGDATA} -w

exit 0
3. オンラインリカバリ後のスタンバイDB起動スクリプトの作成・配置
オンラインリカバリ後にスタンバイDB起動は、別のスクリプトとして用意する必要がある。本スクリプトの処理の流れを記載する。
- 引数を変数に代入する。
- 実行ユーザーをpostgresとして設定する。
- リカバリ対象となるスタンバイDB(
DEST_NODE_HOST)にSSH接続するための、SSHコマンド文を作成する。 - スタンバイDB起動する。
以下のスクリプトをPgpool-IIの管理対象となるDBサーバーのデータ領域(通常は/var/lib/pgsql/data)に配置する。
pgpool_remote_start
#!/bin/bash
# This script is run after recovery_1st_stage to start Standby node.

set -eu
set -o xtrace

DEST_NODE_HOST="$1"
DEST_NODE_PGDATA="$2"

POSTGRESQL_STARTUP_USER=postgres
SSH_KEY_FILE=id_rsa
SSH_OPTIONS="-o StrictHostKeyChecking=no -o UserKnownHostsFile=/dev/null -i ~/.ssh/${SSH_KEY_FILE}"
SSH_CMD="ssh -T ${SSH_OPTIONS} ${POSTGRESQL_STARTUP_USER}@${DEST_NODE_HOST}"

# DB起動
${SSH_CMD} "/usr/bin/pg_ctl start -D ${DEST_NODE_PGDATA} -w -l /dev/null"

exit 0
フェイルオーバー確認
1. 事前状態確認
それでは実際にフェイルオーバーをさせてみる。まずは、Pgpool-IIの状態を確認する。node_id: 0がprimary、node_id: 1がstandbyとなっている。
[Pgpool]$ psql -p 9999 -x -c "show pool_nodes"
-[ RECORD 1 ]----------+--------------------
node_id                | 0
hostname               | t1117psgl
port                   | 5432
status                 | up
pg_status              | up
lb_weight              | 0.500000
role                   | primary
pg_role                | primary
select_cnt             | 0
load_balance_node      | false
replication_delay      | 0
replication_state      |
replication_sync_state |
last_status_change     | 2023-08-26 23:31:00
-[ RECORD 2 ]----------+--------------------
node_id                | 1
hostname               | t1118psgl
port                   | 5432
status                 | up
pg_status              | up
lb_weight              | 0.500000
role                   | standby
pg_role                | standby
select_cnt             | 0
load_balance_node      | true
replication_delay      | 0
replication_state      | streaming
replication_sync_state | sync
last_status_change     | 2023-08-26 23:31:00
2. マスター側のDBを停止
マスターDBとなるnode_id: 0のDBを停止する。
[Master]# systemctl stop postgresql
3. 実行後ログ確認
Pgpool-IIのログ(/var/log/pgpool_log/pgpool-*.log)に以下の通り出力される。failover.sh実行ログがそのまま出力されていることがわかる。
[Pgpool]$ cat /var/log/pgpool_log/pgpool-Sun.log

~(中略)~

2023-08-27 11:21:30.902: main pid 8071: LOG:  === Starting degeneration. shutdown host t1117psgl(5432) ===
2023-08-27 11:21:30.903: main pid 8071: LOG:  Restart all children
2023-08-27 11:21:30.903: main pid 8071: LOG:  execute command: /var/lib/pgsql/failover.sh  0 t1117psgl  5432 /var/lib/pgsql/data  1 t1118psgl 0 0 5432 /var/lib/pgsql/data t1117psgl 5432
+ FAILED_NODE_ID=0
+ FAILED_NODE_HOST=t1117psgl
+ FAILED_NODE_PORT=5432
+ FAILED_NODE_PGDATA=/var/lib/pgsql/data
+ NEW_MAIN_NODE_ID=1
+ NEW_MAIN_NODE_HOST=t1118psgl
+ OLD_MAIN_NODE_ID=0
+ OLD_PRIMARY_NODE_ID=0
+ NEW_MAIN_NODE_PORT=5432
+ NEW_MAIN_NODE_PGDATA=/var/lib/pgsql/data
+ OLD_PRIMARY_NODE_HOST=t1117psgl
+ OLD_PRIMARY_NODE_PORT=5432
+ POSTGRESQL_STARTUP_USER=postgres
+ SSH_KEY_FILE=id_rsa
+ SSH_OPTIONS='-o StrictHostKeyChecking=no -o UserKnownHostsFile=/dev/null -i ~/.ssh/id_rsa'
+ SSH_CMD='ssh -T -o StrictHostKeyChecking=no -o UserKnownHostsFile=/dev/null -i ~/.ssh/id_rsa postgres@t1118psgl'
+ ssh -T -o StrictHostKeyChecking=no -o UserKnownHostsFile=/dev/null -i '~/.ssh/id_rsa' postgres@t1118psgl /usr/bin/pg_ctl promote -D /var/lib/pgsql/data -w
Warning: Permanently added 't1118psgl,192.168.11.118' (ECDSA) to the list of known hosts.
サーバーの昇格を待っています....完了
サーバーは昇格しました
+ ssh -T -o StrictHostKeyChecking=no -o UserKnownHostsFile=/dev/null -i '~/.ssh/id_rsa' postgres@t1118psgl 'sed -ie "s/^synchronous_standby_names = '\''\*'\''/synchronous_standby_names = '\'''\''/g" /var/lib/pgsql/data/postgresql.conf'
Warning: Permanently added 't1118psgl,192.168.11.118' (ECDSA) to the list of known hosts.
+ ssh -T -o StrictHostKeyChecking=no -o UserKnownHostsFile=/dev/null -i '~/.ssh/id_rsa' postgres@t1118psgl /usr/bin/pg_ctl reload -D /var/lib/pgsql/data -w
Warning: Permanently added 't1118psgl,192.168.11.118' (ECDSA) to the list of known hosts.
サーバーにシグナルを送信しました
+ exit 0
2023-08-27 11:21:31.954: main pid 8071: LOG:  find_primary_node_repeatedly: waiting for finding a primary node
2023-08-27 11:21:31.962: main pid 8071: LOG:  find_primary_node: primary node is 1
2023-08-27 11:21:31.962: main pid 8071: LOG:  failover: set new primary node: 1
2023-08-27 11:21:31.962: main pid 8071: LOG:  failover: set new main node: 1
2023-08-27 11:21:31.965: main pid 8071: LOG:  === Failover done. shutdown host t1117psgl(5432) ===
4. 事後状態確認
Pgpool-IIにてフェイルオーバー後の状態確認を行う。以下の通り、node_id: 1がprimaryに昇格し、node_id: 0がstandbyかつステータスがdownとなっていることが確認できる。
[Pgpool]$ psql -p 9999 -x -c "show pool_nodes"
-[ RECORD 1 ]----------+--------------------
node_id                | 0
hostname               | t1117psgl
port                   | 5432
status                 | down   ←★downに変化している
pg_status              | down   ←★downに変化している
lb_weight              | 0.500000
role                   | standby
pg_role                | unknown ←★unknownになっている
select_cnt             | 0
load_balance_node      | false
replication_delay      | 0
replication_state      |
replication_sync_state |
last_status_change     | 2023-08-27 11:21:31
-[ RECORD 2 ]----------+--------------------
node_id                | 1
hostname               | t1118psgl
port                   | 5432
status                 | up
pg_status              | up
lb_weight              | 0.500000
role                   | primary ←★マスター(=primary)に昇格
pg_role                | primary ←★マスター(=primary)に昇格
select_cnt             | 0
load_balance_node      | true
replication_delay      | 0
replication_state      |
replication_sync_state |
last_status_change     | 2023-08-27 11:21:31
オンラインリカバリ
1. オンラインリカバリ実行
オンラインリカバリはpcp_recovery_node -n [リカバリ対象のDBのnode_id]で実行する。今回は、node_id: 0をスタンバイDBとして復旧させることから、以下の通りコマンドを実行する。Command Successfulと表示されれば、オンラインリカバリ成功となる。
[Pgpool]$ pcp_recovery_node -n 0
Password:
pcp_recovery_node -- Command Successful
2. 実行後ログ確認
マスター側のPostgreSQLのログに、以下の通りスクリプト実行結果が出力される。
[Master]$ cat /var/lib/pgsql/data/log/postgresql-Sun.log

~(中略)~

2023-08-27 11:23:07.101 JST [7329] LOG:  checkpoint complete: wrote 957 buffers (5.8%); 0 WAL file(s) added, 0 removed, 0 recycled; write=95.410 s, sync=0.063 s, total=95.475 s; sync files=252, longest=0.063 s, average=0.001 s; distance=16036 kB, estimate=16662 kB
+ MAIN_NODE_PGDATA=/var/lib/pgsql/data
+ DEST_NODE_HOST=t1117psgl
+ DEST_NODE_PGDATA=/var/lib/pgsql/data
+ MAIN_NODE_PORT=5432
+ DEST_NODE_ID=0
+ DEST_NODE_PORT=5432
+ MAIN_NODE_HOST=t1118psgl
+ REPLUSER=dbrepl
+ POSTGRESQL_STARTUP_USER=postgres
+ SSH_KEY_FILE=id_rsa
+ SSH_OPTIONS='-o StrictHostKeyChecking=no -o UserKnownHostsFile=/dev/null -i ~/.ssh/id_rsa'
+ SSH_CMD='ssh -T -o StrictHostKeyChecking=no -o UserKnownHostsFile=/dev/null -i ~/.ssh/id_rsa postgres@t1117psgl'
+ ssh -T -o StrictHostKeyChecking=no -o UserKnownHostsFile=/dev/null -i '~/.ssh/id_rsa' postgres@t1117psgl '[ -d /var/lib/pgsql/data ] && rm -rf /var/lib/pgsql/data'
Warning: Permanently added 't1117psgl,192.168.11.117' (ECDSA) to the list of known hosts.
+ ssh -T -o StrictHostKeyChecking=no -o UserKnownHostsFile=/dev/null -i '~/.ssh/id_rsa' postgres@t1117psgl '/usr/bin/pg_basebackup -D /var/lib/pgsql/data -h t1118psgl -X stream -c fast -U dbrepl -p 5432 -w'
Warning: Permanently added 't1117psgl,192.168.11.117' (ECDSA) to the list of known hosts.
2023-08-27 11:23:18.370 JST [7329] LOG:  checkpoint starting: immediate force wait
2023-08-27 11:23:18.388 JST [7329] LOG:  checkpoint complete: wrote 4 buffers (0.0%); 0 WAL file(s) added, 0 removed, 0 recycled; write=0.001 s, sync=0.001 s, total=0.019 s; sync files=2, longest=0.001 s, average=0.001 s; distance=16383 kB, estimate=16634 kB
+ ssh -T -o StrictHostKeyChecking=no -o UserKnownHostsFile=/dev/null -i '~/.ssh/id_rsa' postgres@t1117psgl 'touch /var/lib/pgsql/data/standby.signal'
Warning: Permanently added 't1117psgl,192.168.11.117' (ECDSA) to the list of known hosts.
+ ssh -T -o StrictHostKeyChecking=no -o UserKnownHostsFile=/dev/null -i '~/.ssh/id_rsa' postgres@t1117psgl 'sed -ie "s#^primary_conninfo =.*#primary_conninfo = '\''application_name=t1117psgl user=dbrepl passfile='\'''\''/var/lib/pgsql/.pgpass'\'''\'' host=t1118psgl port=5432'\''#g" /var/lib/pgsql/data/postgresql.conf'
Warning: Permanently added 't1117psgl,192.168.11.117' (ECDSA) to the list of known hosts.
+ sed -ie 's/^synchronous_standby_names = '\'''\''/synchronous_standby_names = '\''\*'\''/g' /var/lib/pgsql/data/postgresql.conf
+ /usr/bin/pg_ctl reload -D /var/lib/pgsql/data -w
server signaled
2023-08-27 11:23:18.833 JST [7327] LOG:  received SIGHUP, reloading configuration files
+ exit 0
2023-08-27 11:23:18.833 JST [7327] LOG:  parameter "synchronous_standby_names" changed to "*"
+ DEST_NODE_HOST=t1117psgl
+ DEST_NODE_PGDATA=/var/lib/pgsql/data
+ POSTGRESQL_STARTUP_USER=postgres
+ SSH_KEY_FILE=id_rsa
+ SSH_OPTIONS='-o StrictHostKeyChecking=no -o UserKnownHostsFile=/dev/null -i ~/.ssh/id_rsa'
+ SSH_CMD='ssh -T -o StrictHostKeyChecking=no -o UserKnownHostsFile=/dev/null -i ~/.ssh/id_rsa postgres@t1117psgl'
+ ssh -T -o StrictHostKeyChecking=no -o UserKnownHostsFile=/dev/null -i '~/.ssh/id_rsa' postgres@t1117psgl '/usr/bin/pg_ctl start -D /var/lib/pgsql/data -w -l /dev/null'
Warning: Permanently added 't1117psgl,192.168.11.117' (ECDSA) to the list of known hosts.
waiting for server to start.... done
server started
+ exit 0
2023-08-27 11:23:19.606 JST [19019] LOG:  standby "t1117psgl" is now a synchronous standby with priority 1
2023-08-27 11:23:19.606 JST [19019] STATEMENT:  START_REPLICATION 0/6000000 TIMELINE 2
Pgpool-IIのログ(/var/log/pgpool_log/pgpool-*.log)に以下の通り出力される。
2023-08-27 11:23:17.984: pcp_child pid 9523: LOG:  starting recovering node 0
2023-08-27 11:23:17.996: pcp_child pid 9523: LOG:  executing recovery
2023-08-27 11:23:17.996: pcp_child pid 9523: DETAIL:  starting recovery command: "SELECT pgpool_recovery('replication_mode_recovery_1st_stage', 't1117psgl', '/var/lib/pgsql/data', '5432', 0, '5432', 't1118psgl')"
2023-08-27 11:23:17.996: pcp_child pid 9523: LOG:  executing recovery
2023-08-27 11:23:17.996: pcp_child pid 9523: DETAIL:  disabling statement_timeout
2023-08-27 11:23:18.834: pcp_child pid 9523: LOG:  node recovery, 1st stage is done
2023-08-27 11:23:19.411: pcp_child pid 9523: LOG:  checking if postmaster is started
2023-08-27 11:23:19.411: pcp_child pid 9523: DETAIL:  trying to connect to postmaster on hostname:t1117psgl database:postgres user:postgres (retry 0 times)
2023-08-27 11:23:19.422: pcp_child pid 9523: LOG:  node recovery, node: 0 restarted
2023-08-27 11:23:19.422: pcp_child pid 9523: LOG:  received failback request for node_id: 0 from pid [9523]
2023-08-27 11:23:19.422: pcp_child pid 9523: LOG:  signal_user1_to_parent_with_reason(0)
2023-08-27 11:23:19.422: main pid 8071: LOG:  Pgpool-II parent process received SIGUSR1
2023-08-27 11:23:19.422: main pid 8071: LOG:  Pgpool-II parent process has received failover request
2023-08-27 11:23:19.422: main pid 8071: LOG:  === Starting fail back. reconnect host t1117psgl(5432) ===
2023-08-27 11:23:19.422: main pid 8071: LOG:  Node 1 is not down (status: 2)
2023-08-27 11:23:19.422: main pid 8071: LOG:  Do not restart children because we are failing back node id 0 host: t1117psgl port: 5432 and we are in streaming replication mode and not all backends were down
2023-08-27 11:23:19.422: main pid 8071: LOG:  find_primary_node_repeatedly: waiting for finding a primary node
2023-08-27 11:23:19.435: main pid 8071: LOG:  find_primary_node: standby node is 0
2023-08-27 11:23:19.435: main pid 8071: LOG:  find_primary_node: primary node is 1
2023-08-27 11:23:19.435: main pid 8071: LOG:  failover: set new primary node: 1
2023-08-27 11:23:19.435: main pid 8071: LOG:  failover: set new main node: 0
2023-08-27 11:23:19.435: main pid 8071: LOG:  === Failback done. reconnect host t1117psgl(5432) ===
2023-08-27 11:23:19.435: sr_check_worker pid 9518: LOG:  worker process received restart request
2023-08-27 11:23:19.436: pcp_child pid 9523: LOG:  recovery done
3. 事後状態確認
オンラインリカバリ後の状態確認を行う。node_id: 0がstandbyかつステータスがupになっており、復旧していることが確認できる。
[Pgpool]$ psql -p 9999 -x -c "show pool_nodes"
-[ RECORD 1 ]----------+--------------------
node_id                | 0
hostname               | t1117psgl
port                   | 5432
status                 | up    ←★upに変化している
pg_status              | up    ←★upに変化している
lb_weight              | 0.500000
role                   | standby
pg_role                | standby  ←★standbyに変化している
select_cnt             | 0
load_balance_node      | true
replication_delay      | 0
replication_state      | streaming ←★streamingとなっている
replication_sync_state | sync    ←★syncステータスとなっている
last_status_change     | 2023-08-27 11:23:29
-[ RECORD 2 ]----------+--------------------
node_id                | 1
hostname               | t1118psgl
port                   | 5432
status                 | up
pg_status              | up
lb_weight              | 0.500000
role                   | primary
pg_role                | primary
select_cnt             | 0
load_balance_node      | false
replication_delay      | 0
replication_state      |
replication_sync_state |
last_status_change     | 2023-08-27 11:21:31
以上で、Pgpool-IIを使ってフェイルオーバーとオンラインリカバリを実行するための手順は完了となる。